当企业网站拥有较多产品型号、文章或案例时,站内搜索可以帮助访客直接找到目标内容。但一个只有输入框、没有合理结果排序和错误处理的搜索功能,可能比没有搜索更令人困惑。设计时应同时考虑用户体验、数据维护和搜索引擎抓取边界。
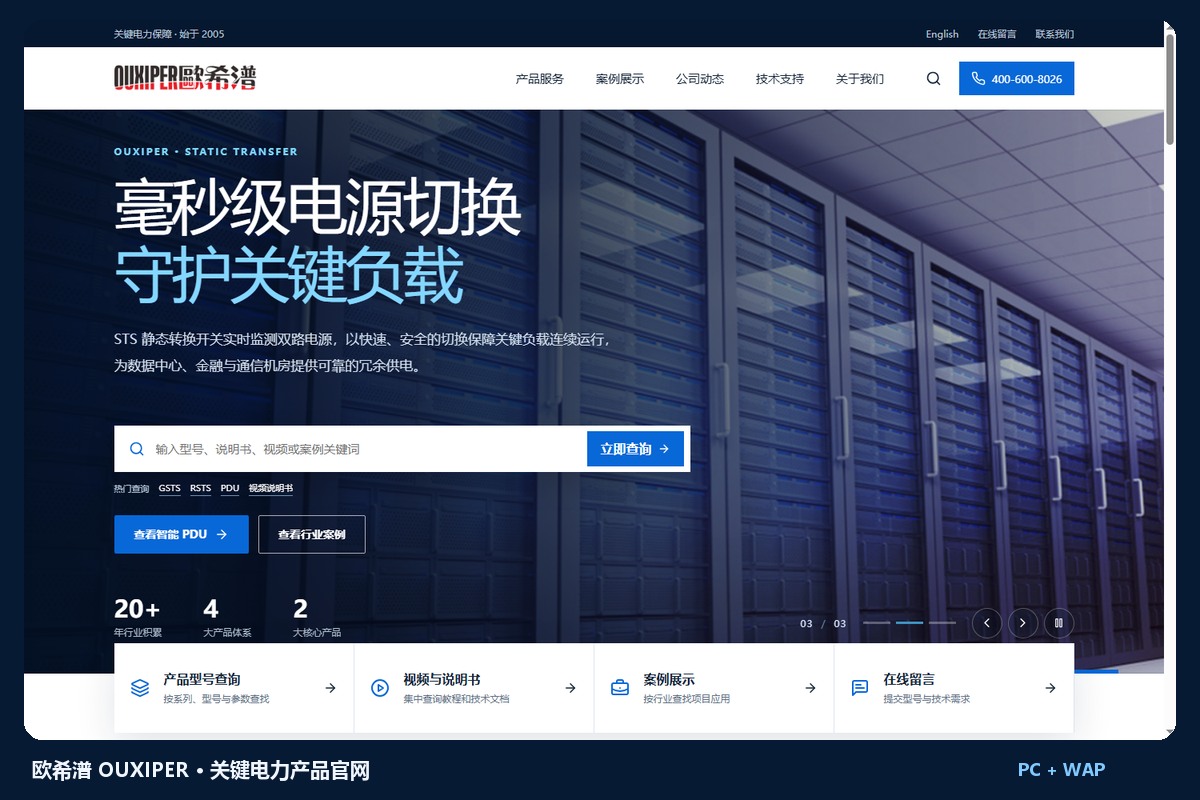
产品网站常见查询包括型号、规格、材料、应用行业和问题描述。搜索索引不应只读文章标题;可根据业务纳入型号、别名、参数、简介和相关案例。输入框应有明确名称,提交后在结果页显示实际查询词,并允许用户修改。对中英文型号、空格和大小写要做合理处理,但不要擅自把不同产品混为一类。
每条结果建议显示标题、类别、简短摘要和必要的产品图片或型号。多类型内容可标注“产品”“案例”“文章”,让用户知道点进去会看到什么。排序可优先考虑精确型号匹配、业务相关性和内容有效性;要让停产或过期内容带上说明。筛选条件应符合真实选型需求,不要为了显得复杂而增加几十个无用选项。
空结果页不要只写“暂无数据”。可提示检查拼写、尝试更短的关键词、浏览产品分类或联系顾问。将无法命中的高频词定期整理给产品和内容团队:它们可能揭示访客正在寻找但网站没有解释的规格、别名或应用问题。记录搜索词时应避免收集和展示不必要的个人信息。
站内搜索产生的查询和筛选组合可能接近无限,不应把每个参数组合都当作要争取收录的独立页面。Google关于分面导航的文档指出,大量筛选URL会占用抓取资源;是否允许抓取和收录,应按页面是否有独立价值决定。普通的临时搜索结果通常无需进入站点地图;确实有稳定需求的产品分类,则应建立内容完整、可通过导航到达的分类页,而不是依赖随机查询页。
实施抓取限制前要区分“搜索结果页”和“产品详情页”,不要误封真实内容。robots.txt、规范网址和页面索引策略各有作用,变更前应在测试环境验证,不能把搜索结果页简单地全部重定向到首页。
站内搜索最有价值的数据,不只是“搜索次数”,而是用户搜索后有没有继续查看产品、下载资料或提交咨询。用这些实际行为持续改进内容和搜索规则,才能让搜索框真正帮助获客。
参考资料:Google Crawling Infrastructure:Managing crawling of faceted navigation URLs。